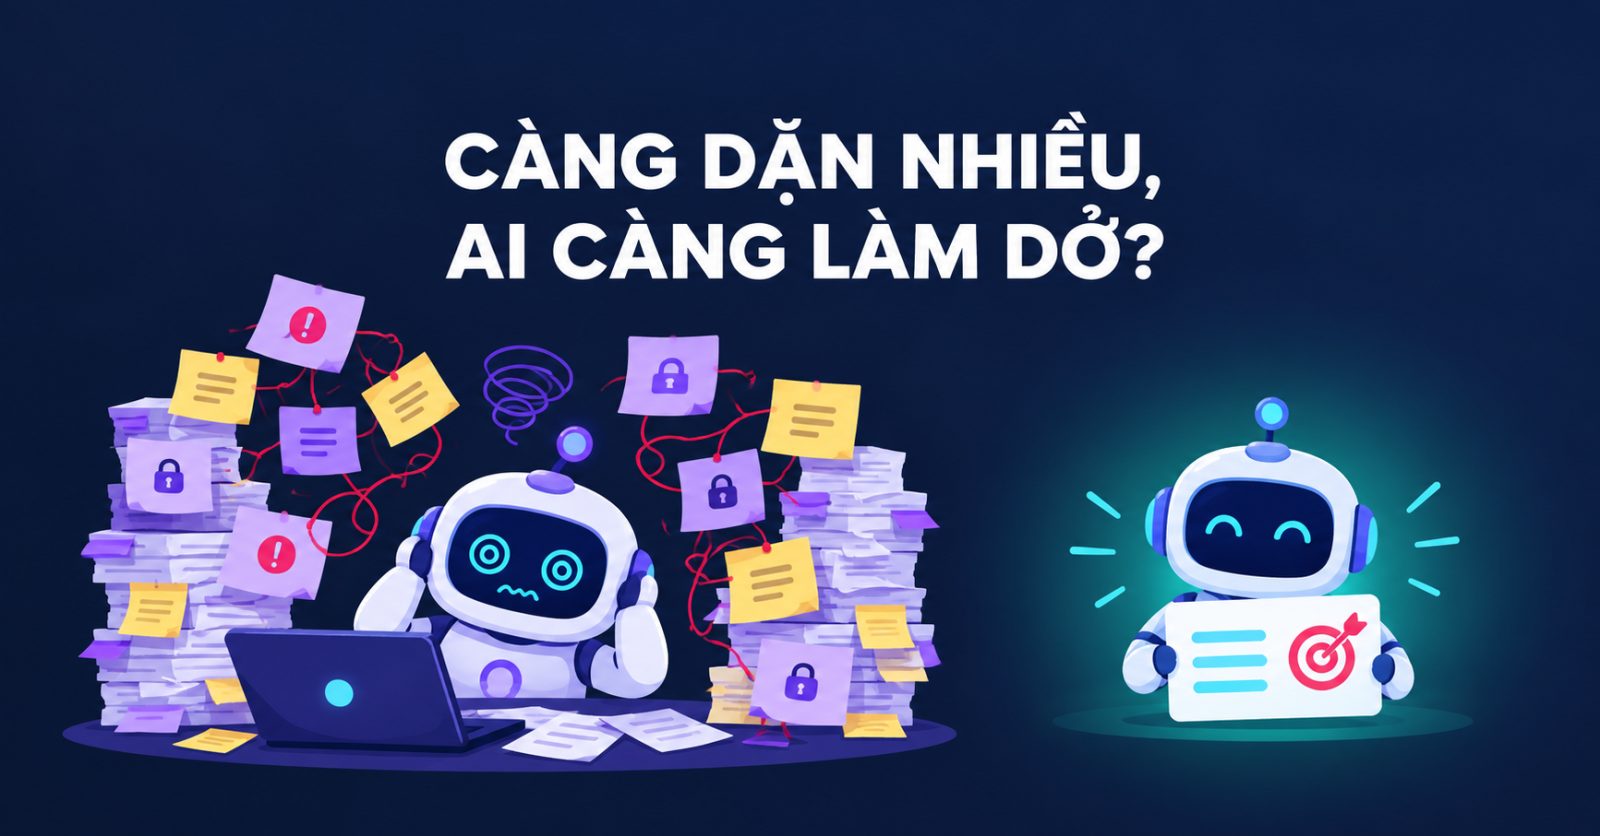
Prompt quá chi tiết là hiện tượng gì?
Prompt quá chi tiết là khi chúng ta đặt cho AI quá nhiều quy tắc, ràng buộc và bước làm cứng, khiến chất lượng đầu ra giảm đi thay vì tăng lên. Trong giới prompt engineering, hiện tượng này có tên là over-specification hoặc over-constraining. Nói nôm na, đó là kiểu mình "quản lý vi mô" AI.
Anthropic mô tả khá tinh tế hai thái cực cần tránh khi viết system prompt. Một bên là nhồi vào prompt thứ logic phức tạp, cứng nhắc và dễ vỡ. Bên kia là chỉ dẫn chung chung, mơ hồ, không cho model một tín hiệu cụ thể nào để bám. Điểm cân bằng mà họ gọi là "right altitude" (độ cao phù hợp) nằm ở tập thông tin tối thiểu nhưng đủ để mô tả hành vi mình mong muốn: đủ cụ thể để dẫn đường, nhưng đủ thoáng để model còn chỗ tự suy luận (Anthropic, 2025).
Có một điểm mình muốn các bạn lưu ý ngay từ đầu: "tối thiểu" không đồng nghĩa với "ngắn". Một prompt dài vì chứa nhiều bối cảnh nghiệp vụ, dữ liệu và ví dụ tốt hoàn toàn có thể rất hiệu quả. Vấn đề nằm ở mật độ quy tắc, nhất là những quy tắc thừa, chồng chéo hoặc tự mâu thuẫn với nhau.
Nghiên cứu nói gì: càng nhiều chỉ dẫn, AI càng dễ trượt
Đây không chỉ là cảm giác chủ quan của người dùng đâu. Từ 2023 đến nay, nhiều nhóm nghiên cứu đã đo được hiện tượng này bằng những con số khá rõ ràng. Mình tóm lại những nghiên cứu đáng chú ý nhất nhé.
"Curse of Instructions": xác suất tuân thủ giảm theo cấp số nhân
Nhóm nghiên cứu của Harada và cộng sự (Đại học Tokyo) đã xây dựng bộ benchmark ManyIFEval, mở rộng từ IFEval, trong đó mỗi prompt chứa từ 1 đến 10 chỉ dẫn có thể kiểm chứng tự động. Họ đặt cho phát hiện của mình một cái tên rất gợi: "Curse of Instructions", lời nguyền của chỉ dẫn. Nội dung của lời nguyền là: xác suất model tuân thủ tất cả chỉ dẫn xấp xỉ bằng xác suất tuân thủ từng chỉ dẫn, lũy thừa lên số lượng chỉ dẫn (Harada et al., OpenReview).
Mình làm một phép tính nhỏ để các bạn thấy nó "đáng sợ" đến mức nào:
| Tỷ lệ tuân thủ mỗi chỉ dẫn | 3 chỉ dẫn | 5 chỉ dẫn | 10 chỉ dẫn |
|---|---|---|---|
| 99% | ~97% | ~95% | ~90% |
| 95% | ~86% | ~77% | ~60% |
| 90% | ~73% | ~59% | ~35% |
Bảng này minh họa theo công thức P(tất cả) ≈ pⁿ, không phải số đo trực tiếp của một model cụ thể.
Trong thí nghiệm thật, nhóm tác giả ghi nhận GPT-4o tuân thủ một chỉ dẫn đơn lẻ ở mức khoảng 85%, nhưng khi phải làm đúng đủ nhiều chỉ dẫn cùng lúc thì tỷ lệ trung bình rơi xuống khoảng 15%; Claude 3.5 Sonnet đi từ khoảng 90% xuống khoảng 44%. Tin vui là khi cho model tự kiểm tra lại (self-refinement) xem mình đã làm đủ chưa, tỷ lệ này nhích lên lần lượt khoảng 31% và 58% (báo cáo tóm tắt nghiên cứu, maxpool.dev).
Đến tháng 9/2025, cùng nhóm tác giả công bố một nghiên cứu tiếp theo, lần này mở rộng sang cả bài toán sinh code (benchmark StyleMBPP) và thử trên 10 model hiện đại. Kết luận vẫn vậy: hiệu năng giảm đều khi số chỉ dẫn tăng, và mức sụt đặc biệt rõ ở chỉ số "đúng tất cả cùng lúc" so với "đúng từng chỉ dẫn riêng lẻ" (Harada et al., arXiv 2509.21051).
IFScale: ngay cả model mạnh nhất cũng chỉ đạt 68% ở 500 chỉ dẫn
Nhóm nghiên cứu của Distyl AI đẩy bài toán lên một quy mô lớn hơn nhiều với benchmark IFScale. Họ yêu cầu model viết báo cáo kinh doanh và phải chèn vào đó tới 500 từ khóa theo chỉ dẫn. Kết quả là ngay cả những model frontier tốt nhất cũng chỉ đạt khoảng 68% độ chính xác ở mật độ tối đa (Jaroslawicz et al., 2025).
Hai phát hiện phụ của IFScale mà mình thấy rất đáng để người viết prompt ghi nhớ:
- Model có thiên hướng ưu tiên các chỉ dẫn xuất hiện sớm trong prompt (primacy bias). Chỉ dẫn nào nằm cuối một danh sách dài thì dễ bị bỏ quên hơn.
- Các model khác nhau suy giảm theo những kiểu khác nhau, tùy kích thước và khả năng suy luận (reasoning). Nghĩa là một prompt "chạy ổn" trên model này chưa chắc đã ổn trên model khác.
"Lost in the Middle" và "Context Rot": prompt càng dài, phần giữa càng dễ bị lờ
Nghiên cứu kinh điển của nhóm Stanford và cộng sự cho thấy hiệu năng của model đi theo hình chữ U tùy vị trí thông tin: cao nhất khi thông tin quan trọng nằm ở đầu hoặc cuối ngữ cảnh, và giảm rõ khi nó rơi vào giữa, kể cả với các model được thiết kế riêng cho ngữ cảnh dài (Liu et al., TACL).
Năm 2025, nhóm Chroma kiểm tra 18 model (trong đó có GPT-4.1, Claude 4, Gemini 2.5, Qwen3) và gọi hiện tượng này là "context rot": hiệu năng thay đổi đáng kể khi độ dài đầu vào tăng, kể cả với những tác vụ đơn giản. Họ cũng nhận thấy chỉ cần một đoạn nội dung "gây nhiễu" (liên quan chủ đề nhưng không trả lời câu hỏi) là đủ để kết quả tụt so với mức cơ sở (Hong, Troynikov & Huber, Chroma).
Liên hệ với chuyện prompt quá chi tiết: mỗi quy tắc không thật sự cần thiết chính là một "distractor" nhỏ. Nó vừa làm prompt dài ra, vừa đẩy chỉ dẫn cốt lõi của các bạn xuống vùng giữa, nơi model hay lơ đãng nhất.
Tóm tắt các nghiên cứu
| Nghiên cứu | Năm | Phát hiện chính liên quan đến prompt quá chi tiết |
|---|---|---|
| Lost in the Middle (Liu et al.) | 2023 | Thông tin ở giữa ngữ cảnh dài bị khai thác kém nhất |
| Curse of Instructions (Harada et al.) | 2025 | Tỷ lệ tuân thủ đủ mọi chỉ dẫn giảm gần theo cấp số nhân |
| IFScale (Jaroslawicz et al.) | 2025 | Model tốt nhất chỉ ~68% ở 500 chỉ dẫn; ưu tiên chỉ dẫn đầu prompt |
| Context Rot (Chroma) | 2025 | 18 model đều suy giảm khi đầu vào dài và có nội dung gây nhiễu |
| When Instructions Multiply (Harada et al.) | 2025 | Suy giảm nhất quán trên cả sinh văn bản lẫn sinh code |
5 cơ chế khiến ràng buộc càng nhiều, AI càng làm dở
Từ các nghiên cứu ở trên cộng với hướng dẫn chính thức của các nhà phát triển model, mình gom lại được năm cơ chế chính:
| Cơ chế | Biểu hiện | Căn cứ |
|---|---|---|
| Ràng buộc xung đột ngầm | Đầu ra lúc theo quy tắc này, lúc theo quy tắc kia; model tốn công "hòa giải" | Hướng dẫn GPT-5 và GPT-4.1 của OpenAI |
| Loãng sự chú ý | Chỉ dẫn quan trọng bị bỏ sót, nhất là ở giữa hoặc cuối danh sách | Curse of Instructions, IFScale, Lost in the Middle |
| Tuân thủ máy móc | Đúng câu chữ nhưng sai ý đồ | Hướng dẫn GPT-4.1 của OpenAI |
| Mất khả năng phán đoán | Chạy tốt với case mẫu, hỏng với case lạ | Khái niệm "right altitude" của Anthropic |
| Nhấn mạnh quá tay | Model áp dụng quy tắc quá mức, cả ở chỗ không liên quan | Tài liệu prompting của Anthropic và OpenAI |
Xung đột ngầm: model phải tự đoán mình muốn gì
OpenAI nói khá thẳng trong hướng dẫn prompting cho GPT-5: prompt chứa chỉ dẫn mâu thuẫn hoặc mơ hồ gây hại cho GPT-5 nhiều hơn so với các model khác. Lý do là model này tuân thủ kỹ đến mức sẽ tiêu tốn "token suy luận" chỉ để cố dung hòa các yêu cầu, thay vì dồn sức làm việc chính (OpenAI, GPT-5 prompting guide).
Ví dụ họ đưa ra là một trợ lý đặt lịch khám bệnh. Prompt vừa dặn "không bao giờ đặt lịch khi chưa có sự đồng ý của bệnh nhân", lại vừa dặn "tự động gán khung giờ sớm nhất trong ngày mà không cần liên hệ bệnh nhân". Cách sửa của họ không phải là thêm quy tắc, mà là làm rõ thứ bậc: gán lịch sau khi đã thông báo cho bệnh nhân, và nói rõ trường hợp khẩn cấp thì được bỏ qua bước nào.
Với GPT-4.1, OpenAI còn ghi nhận một chi tiết khá bất ngờ: khi có chỉ dẫn xung đột, model thường nghe theo chỉ dẫn nằm gần cuối prompt hơn (OpenAI, GPT-4.1 prompting guide). Nghĩa là thứ tự các dòng trong prompt vô tình quyết định kết quả, chứ không phải ý định thật của các bạn.
Tuân thủ máy móc: model mới càng "nghe lời" theo câu chữ
Cũng trong hướng dẫn GPT-4.1, OpenAI lưu ý rằng model mới làm theo chỉ dẫn sát chữ hơn các thế hệ trước, nên những prompt từng tối ưu cho model cũ có thể không còn chạy đúng. Điều này kéo theo một hệ quả nhỏ mà thấm: mỗi quy tắc các bạn viết ra sẽ được thi hành nghiêm túc hơn, kể cả những quy tắc mình viết vội, hay chỉ đúng trong một vài tình huống.
Nhấn mạnh quá tay: "CRITICAL" và "MUST" đang phản tác dụng
Anthropic khuyến nghị với các model Claude đời mới: vì model đã phản hồi system prompt tốt hơn, những prompt từng phải viết mạnh tay (kiểu "CRITICAL: You MUST…") nay có thể khiến model kích hoạt quá mức. Cách sửa của họ rất đơn giản: hạ giọng về cách viết bình thường, kiểu "Dùng công cụ này khi…" (Anthropic, Prompting best practices).
OpenAI cũng khuyên tương tự: thường không cần viết hoa toàn bộ hay "dụ" model bằng phần thưởng, và nếu prompt cũ của các bạn có những kỹ thuật này, model mới có thể để tâm vào chúng quá mức (OpenAI, GPT-4.1 prompting guide).
Góc nhìn của QA: đây chính là "test case viết quá cứng"
Nếu các bạn đã làm tester đủ lâu, chắc hẳn đã từng gặp một bộ test case kiểu này: mỗi bước quy định chính xác click vào đâu, nhập ký tự gì, chờ bao nhiêu giây. Người thực thi làm đúng 100% script, pass hết… nhưng con bug nằm ngay cạnh kịch bản thì chẳng ai nhìn thấy.
Một prompt quá chi tiết cũng y như vậy. Nó biến AI thành một người chạy scripted testing thuần túy, trong khi thứ chúng ta thật sự cần thường giống exploratory testing có charter rõ ràng hơn: biết mục tiêu, biết phạm vi, biết vài rủi ro cần soi kỹ, còn lại để người thực thi tự phán đoán.
| Test case quá cứng | Prompt quá chi tiết |
|---|---|
| Quy định từng click, từng giá trị | Quy định từng câu, từng định dạng |
| Pass script nhưng sót bug ngoài kịch bản | Đúng luật nhưng sai mục đích |
| Tốn công bảo trì mỗi khi UI đổi | Tốn công vá thêm quy tắc mỗi khi đầu ra lệch, hoặc khi đổi model |
| Thuốc chữa: exploratory testing với charter | Thuốc chữa: prompt nêu mục tiêu, bối cảnh, vài giới hạn cốt lõi |
Có một điểm mình thấy khá thú vị: công thức pⁿ của "Curse of Instructions" chính là bài toán xác suất mà dân test đã quen từ lâu. Một hệ thống gồm 10 thành phần nối tiếp, mỗi thành phần tin cậy 95%, thì cả hệ thống chỉ tin cậy khoảng 60%. Một prompt với 10 ràng buộc cũng là một "hệ thống nối tiếp" như thế.
Ví dụ thực tế: sinh test case cho hệ thống đặt phòng họp
Mình quay lại bối cảnh quen thuộc của series: Hệ thống đặt phòng họp nội bộ. Giả sử các bạn nhờ AI sinh test case cho chức năng đặt phòng. (Nếu các bạn chưa quen với việc này, bài prompt mẫu dùng AI viết test case là điểm khởi đầu tốt, còn ở đây mình tập trung vào chuyện prompt bị quá tải.)
Phiên bản prompt quá chi tiết (rút gọn):
Bạn là Senior QA. Sinh test case cho chức năng đặt phòng họp. Mỗi test case PHẢI có đúng 8 cột. KHÔNG được quá 10 test case. PHẢI bao phủ TẤT CẢ trường hợp biên. Viết ngắn gọn nhưng mô tả đầy đủ chi tiết từng bước. Không dùng thuật ngữ tiếng Anh. Tên cột phải là Test Case ID, Precondition, Steps, Expected Result… Mỗi bước tối đa 15 từ. Luôn có ít nhất 3 negative case. TUYỆT ĐỐI không lặp ý. Ưu tiên case quan trọng trước. Sắp xếp theo thứ tự ID tăng dần…
Các bạn thấy những "quả mìn" chưa?
- "Không quá 10 test case" va thẳng vào "bao phủ tất cả trường hợp biên".
- "Viết ngắn gọn" va vào "mô tả đầy đủ chi tiết từng bước".
- "Không dùng thuật ngữ tiếng Anh" nhưng chính tên cột lại bằng tiếng Anh.
- "Ưu tiên case quan trọng trước" va vào "sắp xếp theo ID tăng dần".
- Có tới hơn 10 ràng buộc cùng lúc, đúng cái vùng mà ManyIFEval cho thấy tỷ lệ tuân thủ đủ tất cả tụt mạnh.
Kết quả thường là AI chọn đại một bên cho mỗi cặp xung đột, và lần chạy sau lại chọn kiểu khác. Nhìn vào, mình dễ tưởng AI "không ổn định", nhưng thật ra chính prompt mới là thứ không ổn định.
Phiên bản gọn, theo kiểu charter:
Bạn là QA đang chuẩn bị test cho chức năng đặt phòng họp của hệ thống nội bộ (người dùng chọn phòng, ngày, khung giờ, số người tham dự).
Mục tiêu: một bộ test case để team manual test chạy trong sprint này, tập trung vào rủi ro trùng lịch và vượt sức chứa phòng, vì đây là hai lỗi người dùng phàn nàn nhiều nhất bản trước.
Bắt buộc: trình bày dạng bảng gồm ID, mô tả, bước thực hiện, kết quả mong đợi, độ ưu tiên. Có cả case hợp lệ và không hợp lệ.
Khi phải đánh đổi: ưu tiên độ bao phủ rủi ro hơn số lượng. Nếu thấy thiếu thông tin nghiệp vụ, hãy ghi giả định của bạn ở cuối thay vì tự bịa quy tắc.
Trước khi trả kết quả: tự rà lại bảng xem đã có case cho cả hai rủi ro trên chưa.
Prompt thứ hai ngắn hơn nhưng lại cho AI nhiều thứ đáng giá hơn: lý do (vì sao phải tập trung vào trùng lịch), thứ tự ưu tiên khi xung đột (đúng cách OpenAI sửa ví dụ đặt lịch khám), quyền được phán đoán (ghi giả định), và một bước tự kiểm tra (tận dụng hiệu quả self-refinement mà nghiên cứu Curse of Instructions đã chỉ ra). Theo trải nghiệm của mình, đầu ra ổn định và hữu ích hơn hẳn.
7 cách viết prompt vừa đủ, có căn cứ
Nếu các bạn đang học prompt theo khung structured prompt 6 thành phần (role, context, instruction, input, constraints, output format) như trong syllabus ISTQB CT-GenAI, mình muốn nhắc nhỏ: sáu thành phần là để không thiếu, chứ không phải để nhồi hai mươi quy tắc vào mỗi ô. Riêng phần constraints càng nên tinh gọn.
- Nói mục tiêu và lý do, không chỉ quy tắc. Anthropic có một ví dụ mình rất thích: thay vì "KHÔNG BAO GIỜ dùng dấu ba chấm", hãy nói "câu trả lời sẽ được đọc bằng máy chuyển văn bản thành giọng nói, nên đừng dùng dấu ba chấm vì máy không biết đọc". Model đủ thông minh để khái quát hóa từ lời giải thích, tự suy ra nhiều quy tắc con mà các bạn không cần viết (Anthropic).
- Phân tầng ưu tiên và nói rõ ai thắng khi xung đột. Tách phần bắt buộc (chỉ vài điều) khỏi phần nên có. Đây chính là cách OpenAI sửa ví dụ trợ lý đặt lịch khám: không thêm luật, mà làm rõ thứ bậc giữa các luật.
- Dùng ví dụ thay cho luật. Anthropic xem ví dụ là một trong những cách đáng tin cậy nhất để định hướng định dạng, giọng văn và cấu trúc đầu ra; họ gợi ý khoảng 3–5 ví dụ đa dạng, sát với tình huống thật.
- Đặt thứ quan trọng ở đúng chỗ. Với prompt dài, Anthropic khuyên đặt tài liệu, dữ liệu dài lên đầu và câu hỏi ở cuối; cách này có thể cải thiện chất lượng tới 30% trong thử nghiệm của họ. OpenAI thì thấy với GPT-4.1, đặt chỉ dẫn ở cả đầu và cuối ngữ cảnh dài cho kết quả tốt hơn chỉ đặt một chỗ. Cả hai đều khớp với phát hiện "Lost in the Middle".
- Cắt tỉa định kỳ, đặc biệt khi đổi model. Hãy rà prompt như rà regression suite: bỏ quy tắc trùng lặp, lỗi thời, hoặc những điều model vốn đã làm đúng rồi. Cả Anthropic lẫn OpenAI đều nhắc rằng prompt tối ưu cho model cũ có thể gây "kích hoạt quá mức" trên model mới.
- Chia nhỏ nhiệm vụ và thêm bước tự kiểm tra. Nếu một prompt phải gánh quá nhiều ràng buộc, các bạn hãy tách thành chuỗi nhiều bước (prompt chaining), mỗi bước ít ràng buộc hơn. Thêm một bước để model tự rà lại kết quả, vì nghiên cứu Curse of Instructions cho thấy self-refinement giúp tăng đáng kể tỷ lệ tuân thủ. Và nếu muốn đi xa hơn nữa, hãy để một phiên chat khác làm việc kiểm tra đó: trong thí nghiệm AI tự chấm test case mình đã đo được rằng người kiểm độc lập bắt lỗi tốt hơn hẳn tác giả tự kiểm.
- Đo, đừng đoán. Chuẩn bị một bộ input cố định, chạy trước và sau khi thêm hoặc bớt một quy tắc rồi so sánh. Nghiên cứu "When Instructions Multiply" cho thấy chỉ vài trăm mẫu đã đủ để ước lượng khá tin cậy hiệu năng theo số chỉ dẫn. Với team QA, đó chính là tư duy regression test đem áp dụng cho prompt.
Và mình xin nhắc lại nguyên tắc human-in-the-loop: dù prompt gọn hay dài, đầu ra của AI vẫn cần người có chuyên môn kiểm chứng trước khi đưa vào dùng thật. Đó cũng là lý do mình vẫn trả lời "chưa" cho câu hỏi AI có thay thế tester không.
Khi nào thì prompt chi tiết lại là đúng?
Công bằng mà nói, không phải lúc nào chi tiết cũng xấu. Chính Anthropic cũng nhấn mạnh model phản hồi tốt với chỉ dẫn rõ ràng, trực tiếp, và nếu muốn model làm nhiều hơn mức tối thiểu thì phải nói ra, đừng trông chờ model tự đoán. Prompt nên cụ thể khi:
- Định dạng đầu ra phải khớp máy đọc, ví dụ JSON để import vào tool quản lý test, hay XML để đưa vào ngân hàng câu hỏi.
- Có quy định bắt buộc từ bên ngoài, như quy chuẩn đặt tên của dự án hay yêu cầu bảo mật dữ liệu.
- Các bạn đã thử và thấy AI sai lặp lại ở đúng một điểm, thì thêm đúng một quy tắc cho điểm đó, kèm lý do.
Điểm khác biệt nằm ở chỗ: chi tiết có chủ đích. Rõ ràng (clear) khác với quá tải (overloaded). Mỗi ràng buộc đều phải trả lời được câu hỏi "nếu bỏ dòng này thì chuyện gì xảy ra?". Nếu mình không trả lời được, có lẽ dòng đó nên đi.
Viết prompt tốt, suy cho cùng, cũng giống viết một test charter tốt: rõ mục tiêu, rõ rủi ro, và đủ tin để người thực thi được dùng phán đoán của mình. 🌱 Nếu các bạn muốn luyện kỹ năng này một cách bài bản, từ khung prompt cấu trúc đến việc ứng dụng AI vào sinh test case, review requirement và phân tích lỗi, hãy ghé xem khóa AI cho Tester của IT LEARN nhé.
Tài liệu tham khảo
- Anthropic (2025). Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic. Prompting best practices (Claude Docs). https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
- OpenAI. GPT-5 prompting guide (OpenAI Cookbook). https://developers.openai.com/cookbook/examples/gpt-5/gpt-5_prompting_guide
- OpenAI. GPT-4.1 prompting guide (OpenAI Cookbook). https://developers.openai.com/cookbook/examples/gpt4-1_prompting_guide
- Harada, K., Yamazaki, Y., Taniguchi, M., Kojima, T., Iwasawa, Y., Matsuo, Y. (2025). Curse of Instructions: Large Language Models Cannot Follow Multiple Instructions at Once. OpenReview. https://openreview.net/forum?id=R6q67CDBCH — bản tóm tắt kết quả: https://maxpool.dev/research-papers/curse_of_instructions_report.html
- Harada, K. et al. (2025). When Instructions Multiply: Measuring and Estimating LLM Capabilities of Multiple Instructions Following. arXiv:2509.21051. https://arxiv.org/abs/2509.21051
- Jaroslawicz, D., Whiting, B., Shah, P., Maamari, K. (2025). How Many Instructions Can LLMs Follow at Once? arXiv:2507.11538. https://arxiv.org/abs/2507.11538
- Liu, N. F. et al. Lost in the Middle: How Language Models Use Long Contexts. Transactions of the ACL. arXiv:2307.03172. https://arxiv.org/abs/2307.03172
- Hong, K., Troynikov, A., Huber, J. (2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma Research. https://www.trychroma.com/research/context-rot
Bình luận (0)
Chưa có bình luận nào. Hãy là người đầu tiên!